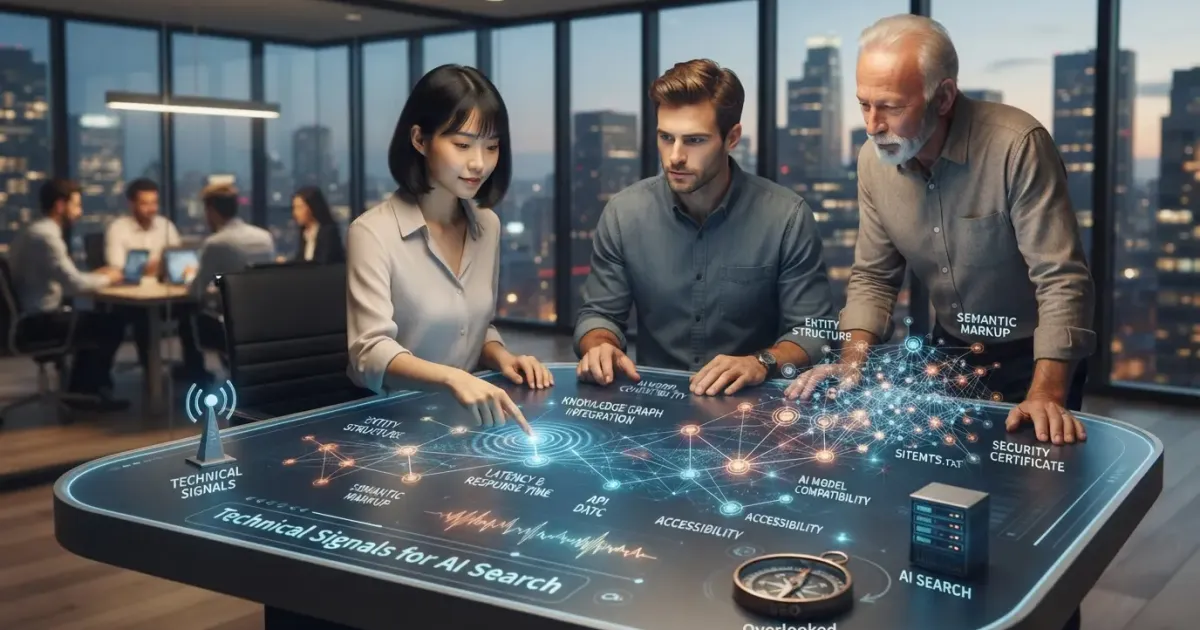
Technical signals AI search tidak berhenti pada crawlability, robots.txt, atau kemampuan bot membaca HTML. Audit terhadap 50 website besar yang dibahas Search Engine Journal menunjukkan bahwa banyak situs sudah relatif baik dalam membuat konten mudah ditemukan, tetapi jauh lebih lemah ketika AI harus memahami siapa pemilik informasi, apa arti sebuah entity, dan apakah agent dapat mengambil tindakan di website tersebut.
Temuan ini dibahas dalam artikel Search Engine Journal tentang technical signals untuk AI search yang masih sering diabaikan SEO. Reza Moaiandin dan tim SALT.agency membangun framework AI readiness tiga lapis: Retrievability, Attribution and Meaning, serta Agent Transaction and Discovery.
Framework tersebut penting dibaca dengan konteks yang benar. Ini merupakan audit framework yang dikembangkan penulis berdasarkan sekumpulan protokol dan signal yang mereka klasifikasikan sebagai established, emerging, atau frontier. Jadi hasilnya bukan daftar resmi ranking factor dari Google, OpenAI, Anthropic, atau vendor AI lainnya.
Daftar Isi
- Apa Tiga Lapisan AI Visibility dalam Framework Ini?
- Bagaimana Audit 50 Website Ini Dilakukan?
- Berapa Skor Rata-Rata Website yang Diaudit?
- Layer 1: Apa Itu Retrievability?
- Kenapa Retrievability Sudah Relatif Baik?
- Apa Peran Semantic HTML untuk AI?
- Apa Itu Token-Efficient DOM Density?
- Kenapa Server-Rendered HTML Masih Penting?
- Layer 2: Apa Itu Attribution and Meaning?
- Seberapa Banyak Website Sudah Menggunakan JSON-LD?
- Apakah Schema Dijamin Meningkatkan Citation?
- Apa Itu Content Signals Policy?
- Kenapa Robots.txt untuk AI Perlu Diputuskan Secara Sengaja?
- Kenapa Skor Rendah Tidak Selalu Buruk?
- Layer 3: Apa Itu Agent Transaction and Discovery?
- Kenapa OAuth Discovery Relevan untuk AI Agent?
- Apa Hubungannya dengan MCP?
- Apa Hubungannya dengan UCP dan Agentic Commerce?
- Apa Status llms.txt dalam Framework Ini?
- Kenapa llms.txt Tidak Cukup Sendiri?
- Apakah robots.txt Bisa Memaksa Semua AI Bot?
- Apa Arti “Signals Are Not Guarantees”?
- Apa Prioritas Audit yang Masuk Akal?
- Prioritas 1: Retrievability
- Prioritas 2: Attribution dan Meaning
- Prioritas 3: Agent Capability
- Bagaimana Tim SEO Harus Bekerja dengan Engineering?
- Apakah Semua Website Perlu Agent Transaction Layer?
- Apa Risiko Membiarkan Default Lama Menentukan AI Strategy?
- Checklist Technical Signals untuk AI Search
- FAQ tentang Technical Signals AI Search
- Apa technical signal terpenting untuk AI search?
- Berapa skor retrievability rata-rata dari audit tersebut?
- Di mana gap terbesar ditemukan?
- Apakah JSON-LD meningkatkan AI citation?
- Apakah llms.txt sudah menjadi standar?
- Haruskah semua AI crawler dibuka?
- Apakah robots.txt bisa memaksa AI bot?
- Kesimpulan
Apa Tiga Lapisan AI Visibility dalam Framework Ini?
Framework SEJ membagi kesiapan website untuk AI menjadi tiga tahap: apakah AI bisa mengambil konten, apakah AI bisa memahami serta mengatribusikannya dengan benar, dan apakah AI agent bisa berinteraksi dengan website untuk menyelesaikan tugas.
Lapisan | Pertanyaan Utama | Contoh Signal |
|---|---|---|
Retrievability | Bisakah AI mengambil dan membaca konten? | robots.txt, semantic HTML, server-rendered content, sitemap |
Attribution & Meaning | Bisakah AI memahami arti konten dan siapa pemiliknya? | JSON-LD, entity meaning, content signals |
Agent Transaction & Discovery | Bisakah AI agent mengambil action dengan aman? | OAuth discovery, MCP, UCP, agent protocols |
Analogi sederhananya: membaca tidak sama dengan memahami, dan memahami tidak sama dengan bisa bertindak.
Dalam information retrieval, sistem dapat berhasil menemukan dokumen tetapi tetap salah menafsirkan entity atau relationship di dalamnya. Framework ini mencoba memperluas technical SEO dari sekadar “bisa ditemukan” menjadi “bisa dipahami dan digunakan”.
Bagaimana Audit 50 Website Ini Dilakukan?
Tim SALT.agency mengaudit 50 website besar dari sektor retail, SaaS, travel, publishing, dan finance. Semua data dikumpulkan pada hari yang sama, 12 Juni 2026.
Mereka menggunakan instrumented browser untuk menangkap:
- live HTTP responses;
- rendered DOM;
- raw server HTML;
- machine-discovery endpoints.
Framework lengkapnya berisi 27 audit element: 11 untuk Layer 1, tiga untuk Layer 2, dan 13 untuk Layer 3.
Namun scoring final hanya menggunakan 12 signal yang mereka klasifikasikan sebagai Established. Signal Emerging dan Frontier tetap dipantau tetapi tidak masuk nilai akhir.
Berapa Skor Rata-Rata Website yang Diaudit?
Secara keseluruhan, rata-rata website hanya mengimplementasikan sedikit lebih dari setengah established protocols yang dinilai.
Metrik | Hasil |
|---|---|
Rata-rata skor keseluruhan | 56,6% |
Median | 58,3% |
Website dengan skor di bawah 50% | 10 dari 50 |
Skor tertinggi | Airbnb, 79,2% |
Namun angka keseluruhan menyembunyikan perbedaan besar antar-layer.
Retrievability sudah relatif matang. Attribution dan meaning jauh lebih lemah. Agent transaction hampir belum diadopsi.
Layer 1: Apa Itu Retrievability?
Retrievability menjawab apakah AI dapat mengambil, parse, dan memahami struktur dasar halaman tanpa tersandung technical barrier.
Ini adalah layer yang paling dekat dengan technical SEO tradisional.
Delapan established audit element yang masuk penilaian adalah:
- robots.txt dan AI user-agent directives;
- accessibility tree integrity;
- ARIA labeling dan descriptive names;
- semantic HTML dan document hierarchy;
- token-efficient DOM density;
- server-rendered atau clean HTML delivery;
- form dan input machine usability;
- sitemap declaration.
Rata-rata skor layer ini adalah 74,4%. Hanya tiga website yang memperoleh skor di bawah 50%.
Kenapa Retrievability Sudah Relatif Baik?
Karena banyak signal-nya sudah lama menjadi praktik web engineering dan technical SEO.
Semantic HTML, sitemap, server rendering, accessibility, serta clean document hierarchy bukan konsep yang lahir karena AI search.
Website yang sudah memiliki technical foundation kuat sering otomatis memiliki sebagian kebutuhan retrievability.
Namun artikel SEJ menekankan bahwa retrievability hanya lapisan pertama. Website yang dapat dibaca belum tentu dapat diinterpretasikan dengan confidence tinggi.
Apa Peran Semantic HTML untuk AI?
Semantic HTML memberi struktur eksplisit pada halaman.
Contohnya:
<main>
  <article>
    <h1>...</h1>
    <section>
      <h2>...</h2>
    </section>
  </article>
</main>
Struktur seperti ini membantu membedakan content utama, heading hierarchy, navigation, form, dan elemen lain.
Ini tidak berarti semantic HTML adalah “AI ranking factor”. Dalam framework SALT, ia masuk sebagai established signal yang membantu retrievability dan machine interpretation.
Apa Itu Token-Efficient DOM Density?
Istilah ini digunakan framework untuk menilai seberapa padat content berguna dibanding markup atau elemen DOM yang tidak perlu.
Halaman dengan struktur sangat bengkak dapat memiliki banyak:
- wrapper;
- inline script;
- duplicated navigation;
- hidden elements;
- UI boilerplate.
Semakin banyak noise, semakin besar processing overhead ketika sistem perlu mengekstrak content utama.
Namun artikel tidak menyajikan threshold universal untuk “DOM density yang ideal”. Jadi ini lebih tepat digunakan sebagai audit concept daripada angka target tertentu.
Kenapa Server-Rendered HTML Masih Penting?
Clean atau server-rendered HTML membuat content utama tersedia dalam initial response tanpa terlalu bergantung pada client-side rendering.
Ini membantu crawler atau agent yang kemampuan JavaScript-nya tidak identik dengan browser manusia.
Namun again, sumber tidak menyatakan semua client-side rendered website otomatis buruk untuk AI search.
Nilai utamanya adalah mengurangi ketergantungan pada rendering tambahan untuk menemukan informasi utama.
Layer 2: Apa Itu Attribution and Meaning?
Layer ini menilai apakah AI dapat memahami apa arti informasi di halaman dan siapa entity yang terkait dengannya.
Rata-rata skor turun tajam menjadi hanya 38,5%.
Dua established signal yang dinilai adalah:
- JSON-LD schema dan semantic richness;
- Content Signals Policy.
Inilah layer yang menurut penulis paling menunjukkan gap antara website yang sekadar crawlable dengan website yang mudah dipahami mesin.
Seberapa Banyak Website Sudah Menggunakan JSON-LD?
Dari 50 homepage yang diaudit, 35 atau 70% memiliki JSON-LD structured data.
Hampir semuanya mendapatkan skor maksimal dalam elemen tersebut.
Namun itu masih menyisakan hampir sepertiga website tanpa JSON-LD pada homepage yang diuji.
Penulis berargumen bahwa schema membantu AI memahami relationship seperti:
- ini adalah produk;
- ini adalah harga;
- ini adalah brand;
- ini adalah author;
- ini adalah organization.
Tanpa schema, model masih dapat mencoba menebak dari halaman. Tetapi kemungkinan salah interpretasi tetap ada.
Apakah Schema Dijamin Meningkatkan Citation?
Tidak. Ini perlu dibedakan dari klaim penulis bahwa schema meningkatkan confidence interpretasi.
Artikel SEJ menyatakan bahwa pemahaman yang lebih baik dapat meningkatkan kemungkinan citation dan mengurangi misrepresentation, tetapi audit tersebut sendiri tidak melakukan controlled experiment yang membuktikan bahwa penambahan JSON-LD menyebabkan citation naik.
Jadi framing yang aman:
Schema:
membantu mendeskripsikan meaning secara eksplisit.

Belum terbukti dari audit ini:
schema = citation boost tertentu.
Apa Itu Content Signals Policy?
Cloudflare Content Signals Policy adalah seperangkat directive dalam robots.txt yang dimaksudkan untuk menyatakan bagaimana crawler boleh menggunakan content dalam konteks search indexing, AI query responses, dan model training.
Dalam audit, hanya 5 dari 50 website yang mengimplementasikannya.
Penulis melihat ini sebagai cara bergerak dari pilihan biner:
block all AI
atau
allow all AI
menuju kebijakan yang lebih granular.
Namun SEJ juga menegaskan bahwa content signals merupakan preference statement. Tidak ada mekanisme teknis yang memaksa semua bot mematuhinya.
Kenapa Robots.txt untuk AI Perlu Diputuskan Secara Sengaja?
Temuan yang cukup besar adalah 29 dari 50 website tampaknya tidak memiliki keputusan eksplisit mengenai akses AI agent.
Mereka tidak secara jelas memblokir atau mengizinkan bot tertentu.
Menurut penulis, ini membuat kebijakan akses “ditinggalkan pada chance”.
Sementara beberapa brand besar justru mengambil keputusan sangat eksplisit.
BBC, CNN, dan The Guardian memblokir banyak AI bot. Amazon juga memiliki directive yang membatasi sebagian besar bot AI.
Sebaliknya, Airbnb dan Cloudflare tidak memiliki blanket block tetapi menetapkan aturan terhadap berbagai bot tertentu.
Jadi “AI readiness” tidak selalu berarti membiarkan semua crawler masuk.
Kenapa Skor Rendah Tidak Selalu Buruk?
Karena business model berbeda.
Publisher mungkin memiliki insentif untuk membatasi AI crawler agar content tidak digunakan tanpa kunjungan langsung.
Retailer, SaaS, travel, atau financial service bisa memiliki insentif berbeda karena ingin produk atau layanan mereka muncul dalam AI recommendation.
Artikel SEJ bahkan menggunakan Amazon sebagai contoh. Amazon memperoleh skor keseluruhan rendah, sekitar 29,2%, tetapi penulis tidak menganggap itu karena mereka lupa soal AI.
Kebijakan bot mereka terlihat deliberate.
Pelajarannya: technical signal bukan checklist yang harus selalu dimaksimalkan sampai 100%.
Layer 3: Apa Itu Agent Transaction and Discovery?
Layer ketiga menilai apakah AI agent dapat menemukan capability website dan mengambil action dengan aman.
Di sinilah skor rata-rata jatuh drastis menjadi hanya 2,1%.
Dari 13 elemen dalam layer ini, hanya dua yang dikategorikan Established dan ikut scoring:
- OAuth Discovery atau Authorization Server Metadata;
- OAuth Protected Resource Metadata.
Untuk 48 website yang bisa diuji endpoint-nya, 46 memperoleh skor nol.
Airbnb dan Vercel memiliki OAuth authorization server metadata, tetapi tidak memiliki protected resource metadata dalam audit tersebut, sehingga masing-masing hanya mendapat 50% pada Layer 3.
Kenapa OAuth Discovery Relevan untuk AI Agent?
AI agent yang ingin berinteraksi dengan sebuah service perlu memahami bagaimana melakukan authorization secara aman.
OAuth discovery metadata dapat membantu client mengetahui:
- authorization endpoint;
- token endpoint;
- supported mechanism;
- identity requirements;
- protected resource information.
Ini bukan fitur SEO tradisional, tetapi menjadi penting ketika agent perlu mengambil action atas nama user.
Apa Hubungannya dengan MCP?
Framework juga memantau sejumlah emerging signal terkait Model Context Protocol (MCP).
MCP memungkinkan AI system terhubung langsung ke tool atau server tertentu.
Dalam konteks ecommerce, misalnya:
Tanpa direct tool:
AI membaca product pages satu per satu.

Dengan direct server/tool:
AI mengambil data langsung dari product database.
Penulis melihat pendekatan langsung seperti ini berpotensi mengurangi processing dan risiko salah interpretasi.
Namun signal MCP tertentu masih dikategorikan sebagai Emerging, bukan Established.
Apa Hubungannya dengan UCP dan Agentic Commerce?
Artikel juga menyebut Google Universal Commerce Protocol (UCP) dan OpenAI Agentic Commerce Protocol (ACP) sebagai protocol baru yang berpotensi menjadi penting untuk transaksi melalui AI conversation.
Ini menunjukkan bagaimana AI visibility mulai meluas dari:
Can AI find us?
↓
Can AI understand us?
↓
Can AI transact with us?
Untuk website commerce, layer ketiga bisa menjadi area strategis dalam beberapa tahun ke depan.
Jika tim Anda sebelumnya membahas UCP atau WebMCP, artikel internal Gemini Berubah dari Chatbot Menjadi AI Agent: Apa Dampaknya? dapat digunakan sebagai internal link silo setelah URL artikel sebelumnya diverifikasi.
Apa Status llms.txt dalam Framework Ini?
llms.txt diklasifikasikan sebagai Frontier, sehingga tidak masuk scoring.
Alasannya adalah format tersebut belum menjadi ratified standard dan belum memiliki specification body yang disepakati.
Meski begitu, 11 dari 50 website yang diaudit sudah menerbitkannya.
Penulis menggambarkannya sebagai semacam curated guide agar AI memahami content dan structure sebuah website.
Kenapa llms.txt Tidak Cukup Sendiri?
SEJ memberi contoh Expedia.
Expedia memiliki llms.txt yang mendeskripsikan identity dan capability brand dengan cukup rapi.
Namun dalam audit yang sama, Expedia hanya memperoleh skor overall 33,3%.
Penulis mencatat beberapa gap lain:
- tidak ada JSON-LD structured data pada homepage yang diuji;
- tidak ada sitemap declaration;
- hanya sekitar seperempat content yang dikirim server-side.
Analogi penulis: membuat llms.txt tanpa memperbaiki layer lain seperti memasang tanda “open for business” tetapi lupa membuka pintu.
Apakah robots.txt Bisa Memaksa Semua AI Bot?
Tidak.
Artikel menyatakan directive robots.txt merupakan preference statement dan compliance tetap voluntary.
Major crawler seperti GPTBot, ClaudeBot, Google-Extended, dan Applebot-Extended secara umum dikatakan menghormati directive tersebut.
Namun bot lain belum tentu.
Content Signals Policy bahkan memiliki enforcement teknis yang lebih lemah: ia bergantung pada bot yang memilih mematuhi sinyal tersebut.
Apa Arti “Signals Are Not Guarantees”?
Ini salah satu bagian terpenting dari artikel.
Penulis sendiri menegaskan bahwa tidak ada satu technical signal yang menjamin hasil.
Membuat:
- robots.txt lebih granular;
- llms.txt;
- schema;
- OAuth metadata;
tidak otomatis menghasilkan citation, recommendation, atau transaction.
Nilai optimasi berada pada memperkuat sebanyak mungkin signal yang sesuai dengan tujuan bisnis.
Apa Prioritas Audit yang Masuk Akal?
Jangan langsung mengejar protocol yang paling baru. Mulailah dari layer yang sudah established.
Prioritas 1: Retrievability
- audit robots.txt;
- periksa user-agent policy;
- perbaiki semantic HTML;
- pastikan content utama tersedia dengan bersih;
- periksa sitemap;
- audit form dan input accessibility.
Prioritas 2: Attribution dan Meaning
- audit JSON-LD;
- pastikan entity relationship jelas;
- periksa brand/author/product attribution;
- tentukan content-use policy secara sadar.
Prioritas 3: Agent Capability
- evaluasi apakah bisnis memang butuh agent interaction;
- audit OAuth discovery;
- pantau MCP/UCP/WebMCP sesuai use case;
- jangan implementasi protocol hanya untuk mengejar skor.
Bagaimana Tim SEO Harus Bekerja dengan Engineering?
Framework ini menunjukkan bahwa AI readiness tidak bisa menjadi proyek content atau SEO saja.
Retrievability membutuhkan technical SEO dan frontend.
Attribution membutuhkan content, schema, dan data governance.
Agent transaction membutuhkan backend, identity, authorization, API, security, dan product engineering.
Operating model yang masuk akal:
SEO
→ menemukan gap visibility

Engineering
→ mengimplementasikan machine access

Security
→ menentukan permission

Product
→ menentukan action yang boleh dilakukan agent

Content
→ memastikan meaning dan entity benar
Apakah Semua Website Perlu Agent Transaction Layer?
Tidak.
Publisher berita yang monetisasinya bergantung pada pageview mungkin tidak memiliki alasan untuk membuka agent transaction.
Retail, SaaS, travel, atau financial service mungkin melihat manfaat yang lebih besar.
Framework sendiri mengakui scoring ideal harus diberi bobot berdasarkan industri dan business model.
Apa Risiko Membiarkan Default Lama Menentukan AI Strategy?
Penulis menutup artikel dengan satu poin yang cukup kuat: beberapa keputusan AI mungkin sebenarnya sudah dibuat oleh setting lama.
Contohnya:
- legacy robots.txt;
- security policy;
- CDN setting;
- server rendering architecture;
- default bot rule.
Jika tidak diaudit, perusahaan bisa secara tidak sengaja:
- memblokir bot yang sebenarnya ingin mereka izinkan;
- membiarkan bot yang ingin mereka batasi;
- memberikan content tanpa meaning yang cukup jelas;
- tidak memiliki jalur agent yang aman.
Checklist Technical Signals untuk AI Search
Area | Checklist |
|---|---|
Retrievability | robots.txt, semantic HTML, ARIA, SSR, clean DOM, sitemap |
Meaning | JSON-LD, entity relationship, author/brand/product attribution |
Content Use | AI bot directives dan content signals jika sesuai policy |
Agent Access | OAuth discovery dan protected resource metadata |
Emerging | MCP, UCP, WebMCP sesuai use case |
Frontier | llms.txt, diuji hanya jika ada alasan yang jelas |
FAQ tentang Technical Signals AI Search
Apa technical signal terpenting untuk AI search?
Tidak ada satu signal tunggal. Framework SEJ membagi kebutuhan menjadi retrievability, attribution and meaning, serta agent transaction and discovery.
Berapa skor retrievability rata-rata dari audit tersebut?
Rata-rata Layer 1 adalah 74,4%, menunjukkan banyak website besar sudah cukup baik pada technical foundation yang mirip conventional SEO.
Di mana gap terbesar ditemukan?
Agent Transaction and Discovery memiliki skor rata-rata hanya 2,1%, sementara Attribution and Meaning berada di 38,5%.
Apakah JSON-LD meningkatkan AI citation?
Audit menunjukkan JSON-LD membantu mendeskripsikan meaning secara eksplisit, tetapi studi tersebut tidak melakukan controlled test yang membuktikan penambahan schema menyebabkan citation meningkat.
Apakah llms.txt sudah menjadi standar?
Belum. Framework mengklasifikasikannya sebagai Frontier dan tidak memasukkannya ke scoring established signals.
Haruskah semua AI crawler dibuka?
Tidak. Banyak website besar justru membuat keputusan spesifik untuk mengizinkan atau memblokir bot berdasarkan business model mereka.
Apakah robots.txt bisa memaksa AI bot?
Tidak sepenuhnya. Directive robots.txt merupakan preference statement dan bergantung pada compliance crawler.
Kesimpulan
Technical signals AI search lebih luas daripada technical SEO tradisional. Audit 50 website besar dari SALT.agency menunjukkan retrievability sudah relatif matang dengan skor rata-rata 74,4%, tetapi attribution and meaning hanya 38,5% dan agent transaction and discovery hanya 2,1%.
Temuan tersebut memperlihatkan tiga tahap berbeda: AI harus bisa mengambil informasi, memahami meaning serta ownership-nya, lalu—untuk use case tertentu—berinteraksi dengan website secara aman.
Namun framework ini bukan daftar ranking factor resmi. Schema, content signals, OAuth metadata, MCP, UCP, atau llms.txt merupakan technical signals dan protocol dengan tingkat kematangan berbeda. Implementasi harus mengikuti business model, bukan sekadar mengejar skor audit.
Bagi tim SEO dan Generative AI, langkah paling penting adalah membuat keputusan secara sengaja: bot mana yang boleh mengakses content, bagaimana entity dijelaskan, serta apakah website memang perlu mendukung agent transaction.
Jika bisnis Anda ingin melakukan AI readiness audit, memperbaiki technical architecture, structured data, crawler policy, atau menyiapkan website untuk AI agent dan Generative AI search, Anda dapat diskusikan kebutuhan teknologi bisnis kamu bersama tim teknis.

Komentar
Ada pertanyaan atau masukan? Tulis di kolom komentar!