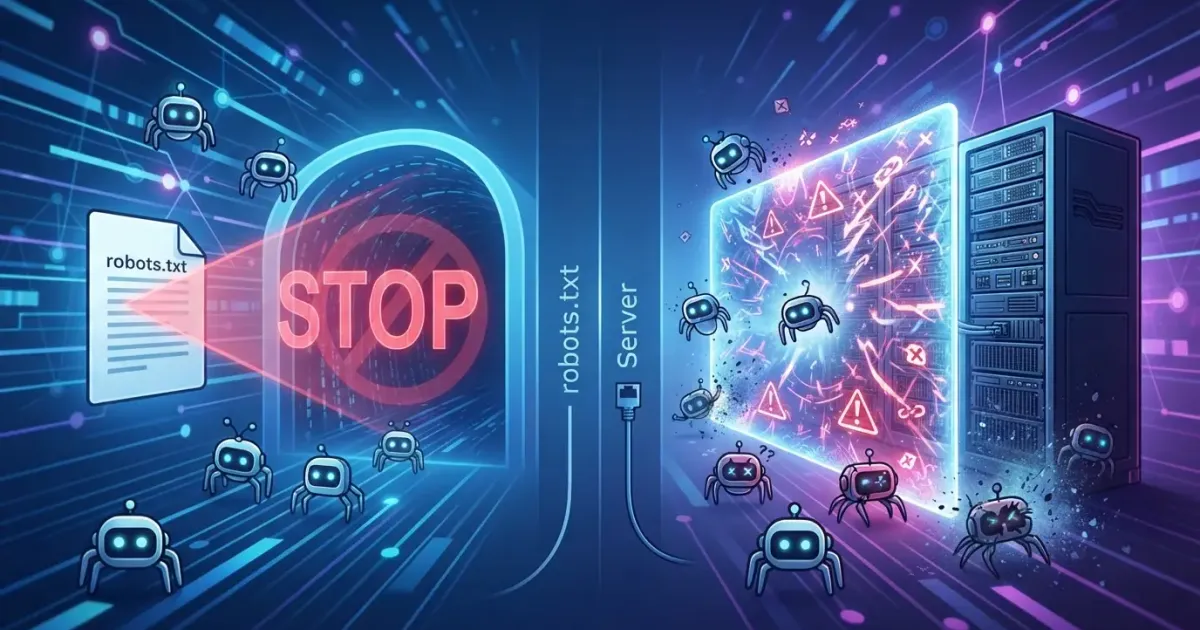
Blokir AI crawler bisa dilakukan dengan beberapa cara, tetapi setiap pendekatan memiliki tingkat efektivitas yang berbeda. Robots.txt adalah cara paling sederhana untuk memberi tahu crawler agar tidak mengakses bagian tertentu dari situs, sementara CDN, Web Application Firewall (WAF), dan server-level rule dapat benar-benar menolak request sebelum konten diberikan.
Dalam pembahasan Search Engine Journal tentang memblokir AI crawler melalui robots.txt atau server, Helen Pollitt menjelaskan bahwa keputusan teknisnya bergantung pada tujuan bisnis, arsitektur website, biaya, dan siapa yang mengelola infrastructure. Tidak ada satu metode yang selalu paling tepat untuk semua situs.
Perbedaan terpentingnya sederhana: robots.txt bergantung pada kepatuhan crawler, sedangkan blocking di WAF, CDN, atau server merupakan enforcement. Kalau crawler mengabaikan instruksi robots.txt, tidak ada mekanisme di file tersebut yang secara fisik menghentikan request.
Daftar Isi
- Apa Bedanya Robots.txt dan Server-Level Blocking untuk AI Crawler?
- Bagaimana Cara Memblokir AI Crawler Melalui Robots.txt?
- Apakah Robots.txt Cukup untuk Memblokir AI Crawler?
- Bagaimana Server-Level Blocking Bekerja?
- Kenapa CDN Lebih Efisien daripada Memblokir di Origin Server?
- Kenapa WAF Dianggap Lapisan Terkuat untuk Memblokir AI Scraper?
- Mana yang Lebih Baik: Robots.txt, CDN, WAF, atau Server?
- Apa Risiko Salah Konfigurasi Robots.txt?
- Apa Risiko Salah Konfigurasi WAF atau CDN?
- Apakah Memblokir AI Crawler Bisa Berdampak pada Visibility di AI Search?
- Bagaimana Menentukan Apakah AI Crawler Layak Diblokir?
- Kenapa Server Logs Penting Setelah Memblokir AI Crawler?
- Kapan Cukup Menggunakan Robots.txt?
- Kapan Harus Naik ke WAF atau CDN?
- FAQ tentang Blokir AI Crawler
- Apakah robots.txt benar-benar bisa menghentikan AI crawler?
- Apakah WAF lebih efektif daripada robots.txt?
- Apakah CDN bisa menghemat bandwidth saat memblokir bot?
- Apakah user-agent cukup untuk mendeteksi AI crawler?
- Apakah semua AI crawler harus diblokir?
- Apa metode terbaik jika saya benar-benar tidak ingin AI scraper mengakses situs?
- Kesimpulan
Apa Bedanya Robots.txt dan Server-Level Blocking untuk AI Crawler?
Robots.txt adalah protokol yang memberi instruksi kepada crawler mengenai area situs yang boleh atau tidak boleh dirayapi. Server-level blocking bekerja di layer request dan dapat menolak koneksi atau response berdasarkan user-agent, IP, header, pola trafik, atau rule lain yang dikonfigurasi administrator.
Konsep robots.txt awalnya dirancang sebagai mekanisme komunikasi antara pemilik situs dan web crawler. File tersebut tidak berfungsi seperti firewall. Artinya, bot yang memilih tidak mematuhi rule tetap secara teknis dapat meminta halaman.
Server, CDN, dan WAF berbeda karena mereka berada di jalur request. Jika rule mendeteksi sebuah request sebagai bot yang harus diblokir, request tersebut dapat dihentikan tanpa crawler perlu “setuju” dengan kebijakan Anda.
Metode | Sifat | Kelebihan Utama | Keterbatasan |
|---|---|---|---|
robots.txt | Deklaratif | Mudah, murah, granular per user-agent/path | Bergantung pada kepatuhan crawler |
Server rule | Enforcement | Bisa menolak request secara langsung | Perlu akses teknis dan maintenance |
CDN | Enforcement di edge | Menghentikan request sebelum origin server | Tergantung fitur provider |
WAF | Enforcement + behavioral filtering | Lebih kuat mendeteksi spoofing dan pola bot | Lebih kompleks dan bisa menambah biaya |
Bagaimana Cara Memblokir AI Crawler Melalui Robots.txt?
Caranya sama seperti memblokir crawler lain: identifikasi user-agent bot, lalu tambahkan rule Disallow pada file robots.txt.
Contohnya, untuk mencegah GPTBot mengakses seluruh situs:
User-agent: GPTBot
Disallow: /
Jika hanya direktori tertentu yang ingin diblokir:
User-agent: GPTBot
Disallow: /products/
Menurut artikel SEJ, sejumlah perusahaan AI besar menyediakan user-agent spesifik, termasuk GPTBot dan OAI-SearchBot dari OpenAI, ClaudeBot dan crawler terkait dari Anthropic, Google-Extended dari Google, serta PerplexityBot dari Perplexity.
Kelebihannya, aturan seperti ini mudah diterapkan dan bisa sangat granular. Anda dapat memblokir satu crawler tetapi mengizinkan crawler lain, atau hanya membatasi direktori tertentu.
Namun kelemahan utamanya tidak berubah: robots.txt adalah permintaan, bukan penghalang teknis. Bot yang tidak patuh tetap bisa mengirim request ke URL yang diblokir.
Apakah Robots.txt Cukup untuk Memblokir AI Crawler?
Robots.txt cukup jika tujuan Anda lebih dekat ke “menyatakan preferensi” terhadap crawler bereputasi baik, bukan memastikan secara mutlak bahwa content tidak dapat diakses.
Dalam analogi sederhana, robots.txt seperti papan “dilarang masuk” di depan gerbang yang tidak terkunci. Crawler yang mematuhi aturan akan berhenti. Crawler yang tidak mematuhi tetap dapat melewatinya.
Untuk situs yang hanya ingin mencegah satu atau dua crawler terkenal, pendekatan ini bisa cukup praktis. Search Engine Journal menyarankan agar server logs tetap dimonitor untuk mengecek apakah bot yang sudah diblokir lewat robots.txt benar-benar berhenti mengakses situs.
Situasinya berbeda jika alasan blocking berkaitan dengan perlindungan intellectual property, beban server, scraping masif, atau kebijakan legal yang membutuhkan enforcement lebih kuat. Dalam kondisi itu, mengandalkan robots.txt saja terlalu lemah.
Bagaimana Server-Level Blocking Bekerja?
Server-level blocking membaca request yang masuk lalu menerapkan aturan berdasarkan atribut seperti user-agent, IP address, header, atau pola request. Jika request memenuhi rule tertentu, server dapat menolaknya.
Secara sederhana, alurnya seperti ini:
Incoming Request
      ↓
Server Rule
      ↓
Apakah request cocok dengan rule bot?
      ↓
Ya → Deny / 403 / Drop
Tidak → Lanjut proses normal
Pendekatan ini lebih kuat dari robots.txt karena crawler tidak diminta untuk patuh. Server mengambil keputusan sendiri untuk menerima atau menolak request.
Kelemahannya, konfigurasi seperti ini biasanya tidak berada di tangan tim SEO. Perubahannya sering membutuhkan developer, DevOps, atau infrastructure engineer, terutama pada lingkungan production yang memiliki change management ketat.
Kenapa CDN Lebih Efisien daripada Memblokir di Origin Server?
CDN dapat menghentikan request sebelum mencapai origin server. Ini mengurangi penggunaan bandwidth, CPU, memory, dan request processing di infrastructure utama.
Bayangkan bot mengirim jutaan request ke halaman produk. Jika blocking baru dilakukan di origin, request tersebut tetap sampai ke server Anda sebelum ditolak. Kalau diblokir di edge CDN, sebagian besar request berhenti lebih awal.
Untuk situs besar atau website yang menghadapi scraping masif, hal ini bisa berpengaruh pada biaya infrastructure dan kestabilan aplikasi.
Search Engine Journal mencontohkan Cloudflare sebagai CDN yang menyediakan preset blocking untuk kategori bot tertentu, termasuk bot pencarian, agent, dan crawler yang digunakan untuk training. Namun implementasi spesifik sangat tergantung provider dan paket layanan yang digunakan.
Kenapa WAF Dianggap Lapisan Terkuat untuk Memblokir AI Scraper?
WAF tidak hanya membaca identitas yang diklaim bot melalui user-agent. Sistem ini juga dapat menganalisis perilaku request, pola trafik, rate, header combination, dan sinyal keamanan lain.
Hal ini penting karena user-agent sangat mudah dipalsukan. Scraper dapat mengubah header agar terlihat seperti browser normal atau bahkan crawler lain yang diizinkan.
Menurut artikel SEJ, WAF menjadi pilihan paling kuat dalam banyak tech stack untuk mendeteksi crawler AI yang lebih canggih dan mencoba menghindari blocking sederhana.
Namun “paling kuat” tidak berarti sempurna. Bot yang sangat canggih tetap dapat mencoba melewati validation checks, menggunakan distributed IP, headless browser, residential proxy, atau teknik lain yang membuat trafik terlihat seperti pengguna manusia.
Dengan kata lain, tujuan realistisnya adalah menaikkan biaya dan kesulitan scraping secara signifikan, bukan berasumsi ada sistem blocking yang mustahil ditembus.
Mana yang Lebih Baik: Robots.txt, CDN, WAF, atau Server?
Jika kebutuhan blocking benar-benar kuat, pendekatan yang lebih masuk akal adalah memblokir sedini mungkin di server stack. Urutan rekomendasi yang diberikan dalam artikel SEJ adalah WAF jika tersedia, lalu CDN, kemudian server-level rule.
- Gunakan WAF jika Anda membutuhkan enforcement kuat dan deteksi perilaku bot yang lebih sophisticated.
- Gunakan CDN blocking jika ingin menghentikan bot sebelum mencapai origin dan menghemat bandwidth.
- Gunakan server rule jika tidak memiliki kontrol pada WAF atau CDN tetapi tetap membutuhkan enforcement.
- Gunakan robots.txt jika Anda hanya perlu meminta crawler bereputasi baik untuk tidak mengakses content tertentu.
Untuk kebutuhan sensitif, kombinasi beberapa layer lebih aman daripada bergantung pada satu kontrol saja.
Apa Risiko Salah Konfigurasi Robots.txt?
Kesalahan paling berbahaya adalah rule yang terlalu luas dan tidak sengaja memblokir crawler penting.
Contohnya:
User-agent: *
Disallow: /
Rule seperti ini meminta seluruh crawler yang mematuhi robots.txt untuk tidak merayapi seluruh situs. Jika diterapkan tanpa sengaja pada website production, dampaknya bisa serius terhadap discovery dan crawling mesin pencari.
Masalah lain adalah maintenance. Daftar AI crawler terus berubah dan user-agent baru bisa muncul. Robots.txt tidak otomatis memperbarui rule ketika perusahaan AI memperkenalkan bot baru.
Karena itu, file ini sebaiknya diperlakukan sebagai konfigurasi production yang memiliki owner, review process, dan version history, bukan file yang diedit sembarang orang tanpa audit.
Apa Risiko Salah Konfigurasi WAF atau CDN?
Risikonya lebih besar karena enforcement terjadi sebelum request mencapai aplikasi. Rule yang salah bisa memblokir pengguna valid, search crawler penting, monitoring service, payment webhook, API partner, atau integrasi internal.
Beberapa risiko umum:
- False positive pada traffic pengguna normal.
- Blocking Googlebot atau crawler search engine secara tidak sengaja.
- Rate limit terlalu agresif.
- Rule IP terlalu luas.
- Cache behavior berubah setelah konfigurasi bot management.
- Traffic API internal ikut terdampak.
Karena itu, deployment rule baru sebaiknya diawali dengan mode monitoring atau logging jika provider mendukungnya. Lihat request yang akan terblokir sebelum benar-benar mengaktifkan deny rule secara penuh.
Apakah Memblokir AI Crawler Bisa Berdampak pada Visibility di AI Search?
Bisa. Keputusan memblokir crawler bukan hanya keputusan infrastructure, tetapi juga keputusan distribusi content.
Jika sebuah sistem AI membutuhkan crawler tertentu untuk menemukan atau mengambil content, blocking dapat mengurangi peluang content tersebut digunakan pada pengalaman AI tertentu. Namun hubungan ini tidak selalu sederhana karena perusahaan AI dapat memiliki beberapa crawler dengan fungsi berbeda.
Karena itu, jangan blokir semua user-agent yang berhubungan dengan satu perusahaan hanya berdasarkan nama brand. Identifikasi dulu fungsi masing-masing crawler: apakah digunakan untuk training, search indexing, user-requested fetch, agent, atau tujuan lain.
Ini juga menjadi alasan mengapa kebijakan blocking sebaiknya dimiliki lintas tim: SEO, legal, security, infrastructure, dan business stakeholder perlu menyepakati tujuan yang sama.
Bagaimana Menentukan Apakah AI Crawler Layak Diblokir?
Mulailah dari tujuan bisnis, bukan dari sentimen umum terhadap AI.
- Identifikasi crawler. Pastikan user-agent dan sumber request benar-benar terkait layanan yang dimaksud.
- Ukur volume request. Lihat server log, bandwidth, response code, dan endpoint yang paling sering diakses.
- Nilai manfaat. Apakah crawler berpotensi menghasilkan referral, citation, discovery, atau visibility?
- Nilai biaya. Hitung bandwidth, CPU, scraping pressure, dan maintenance yang ditimbulkan.
- Tentukan sensitivitas content. Public article berbeda dengan proprietary dataset atau premium content.
- Pilih layer blocking. Gunakan robots.txt untuk deklarasi; gunakan WAF/CDN/server jika enforcement dibutuhkan.
- Monitor setelah implementasi. Pastikan bot target benar-benar berkurang tanpa merusak traffic valid.
Jika tim Anda sebelumnya membahas technical SEO dan crawling, artikel internal Cache Busting Sitemap untuk SEO: Kenapa Google Tidak Merekomendasikannya dapat digunakan sebagai internal link silo setelah URL artikel sebelumnya diverifikasi.
Kenapa Server Logs Penting Setelah Memblokir AI Crawler?
Server logs memberi bukti apakah rule benar-benar bekerja. Tanpa log, tim hanya tahu konfigurasi sudah dipasang, tetapi tidak tahu apakah crawler masih mencoba masuk, berpindah user-agent, atau menggunakan jalur lain.
Data yang sebaiknya dipantau antara lain:
- User-agent.
- IP atau network origin.
- Request path.
- Response code.
- Requests per minute.
- Bandwidth yang digunakan.
- Pola request berulang.
Dari sini, tim bisa melihat apakah robots.txt sudah cukup atau perlu enforcement tambahan.
Kapan Cukup Menggunakan Robots.txt?
Robots.txt masuk akal ketika Anda memblokir crawler reputable yang secara eksplisit menyatakan mengikuti protokol tersebut, traffic bot tidak menimbulkan beban signifikan, dan tidak ada requirement legal atau keamanan yang membutuhkan enforcement.
Contohnya, sebuah blog publik mungkin tidak keberatan content tetap dapat diakses pengguna biasa, tetapi ingin menyatakan bahwa crawler training tertentu tidak boleh merayapi halaman. Dalam kondisi seperti itu, robots.txt memberi kontrol sederhana tanpa menambah complexity infrastructure.
Namun tetap lakukan monitoring. Jika crawler yang ditargetkan terus muncul di logs, tim perlu mengevaluasi apakah identitas bot benar, apakah rule sudah tepat, atau apakah dibutuhkan layer lain.
Kapan Harus Naik ke WAF atau CDN?
Gunakan WAF atau CDN ketika biaya dan risiko akses bot sudah cukup tinggi sehingga sekadar “meminta” crawler berhenti tidak memadai.
Beberapa indikatornya:
- Volume request AI scraper sangat tinggi.
- Origin server mengalami load tambahan.
- Content memiliki nilai komersial tinggi.
- Ada crawler yang mengabaikan robots.txt.
- User-agent sering berubah atau terlihat spoofed.
- Tim membutuhkan log blocking yang lebih jelas.
- Ada kebijakan legal atau lisensi terkait penggunaan content.
Dalam kondisi ini, WAF atau CDN bukan sekadar alat SEO. Ia menjadi bagian dari governance akses content.
FAQ tentang Blokir AI Crawler
Apakah robots.txt benar-benar bisa menghentikan AI crawler?
Tidak secara teknis. Robots.txt adalah deklarasi yang bergantung pada kepatuhan crawler. Bot yang mengabaikannya tetap dapat mengirim request ke server.
Apakah WAF lebih efektif daripada robots.txt?
Ya untuk enforcement. WAF dapat memblokir request berdasarkan rule dan pola perilaku tanpa membutuhkan persetujuan bot.
Apakah CDN bisa menghemat bandwidth saat memblokir bot?
Ya. Karena request dapat dihentikan di edge sebelum mencapai origin, CDN bisa mengurangi bandwidth dan beban server.
Apakah user-agent cukup untuk mendeteksi AI crawler?
Tidak selalu. User-agent dapat dipalsukan. Untuk crawler yang lebih agresif, diperlukan kombinasi behavioral detection, IP intelligence, rate analysis, dan WAF rule.
Apakah semua AI crawler harus diblokir?
Tidak. Keputusan harus mempertimbangkan tujuan bisnis, visibility, biaya infrastructure, sensitivitas content, dan fungsi masing-masing crawler.
Apa metode terbaik jika saya benar-benar tidak ingin AI scraper mengakses situs?
Menurut rekomendasi yang dibahas Search Engine Journal, gunakan blocking setinggi mungkin di server stack: WAF jika tersedia, lalu CDN, lalu server-level rule. Robots.txt dapat tetap digunakan sebagai deklarasi tambahan.
Kesimpulan
Blokir AI crawler tidak punya satu metode yang selalu benar. Robots.txt mudah diterapkan dan efektif untuk crawler reputable yang patuh, tetapi tidak memberikan enforcement teknis.
Jika kebutuhan blocking lebih serius, WAF, CDN, atau server-level rule jauh lebih kuat karena request dapat ditolak sebelum content diberikan. WAF biasanya menawarkan kemampuan paling lengkap untuk menghadapi spoofing dan pola crawler yang lebih kompleks, sementara CDN membantu mengurangi beban origin.
Yang paling penting adalah jangan memblokir berdasarkan asumsi. Identifikasi crawler, ukur manfaat dan biaya, pahami fungsi user-agent, lalu monitor logs setelah rule diterapkan. Blocking AI crawler adalah keputusan SEO, infrastructure, security, dan business sekaligus.
Jika bisnis Anda perlu merancang strategi bot management, konfigurasi CDN/WAF, technical SEO, atau arsitektur crawling yang lebih terkontrol, Anda dapat diskusikan kebutuhan teknologi bisnis kamu bersama tim teknis.

Komentar
Ada pertanyaan atau masukan? Tulis di kolom komentar!